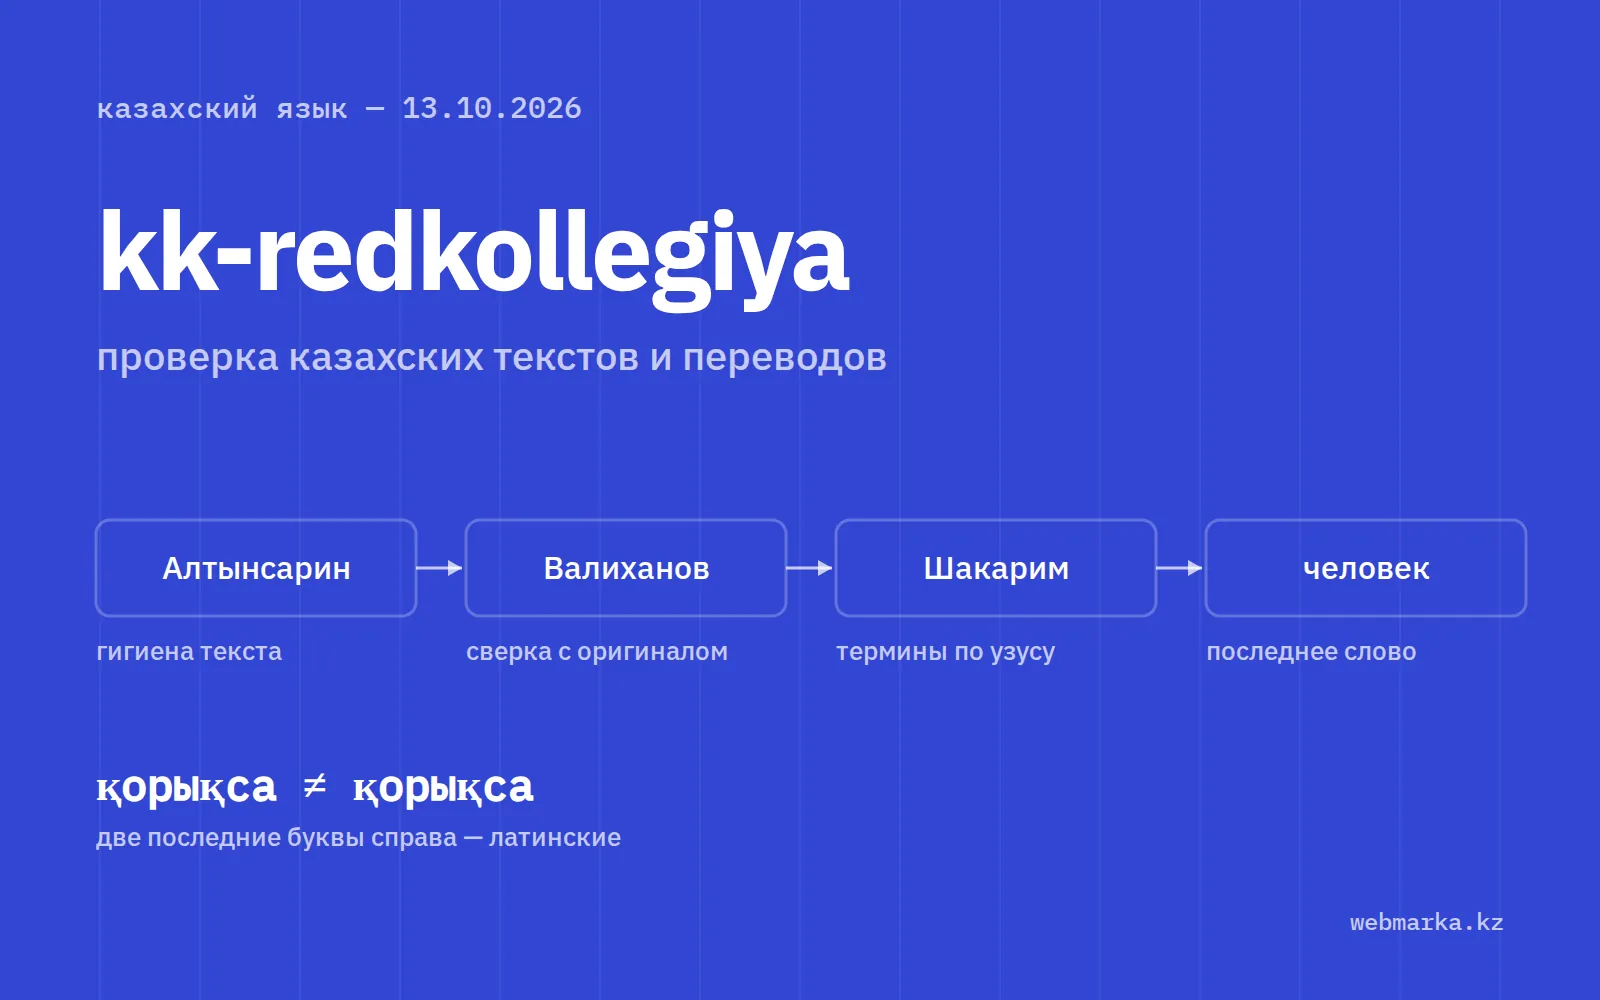
Беда казахского текста в цифровом мире в том, что слово может выглядеть безупречно и быть набрано не теми знаками. Глаз разницы не видит, а поиск, сортировка и проверка орфографии видят сразу: для них это другое слово.
Что ловит набор
- Двойники. Латинская «i» вместо казахской «і», латинская «ə» вместо «ә»: оба знака зовутся «schwa», но в Юникоде это разные символы. В одном электронном издании «Қара сөздер» Абая подменённых «ә» нашлось 1 085.
- Старые кодировки. Текст из PDF, набранного казахскими шрифтами до Юникода, выглядит как «ìåêòåï» вместо «мектеп». Набор сам определяет кодировку и возвращает буквы на место.
- Набор без казахских букв: «Казакстан» вместо «Қазақстан». Символьная модель предлагает исправление и с первой попытки верна в 90,1% слов на книгах, которых не видела.
- Расхождения с оригиналом. На 1 516 парах казахских и русских постов двуязычного канала числа разошлись в 1,7% пар — такие ошибки набор считает блокирующими.
Как устроен
Программы ничего не правят молча. Каждая находка приходит с дословной цитатой и уровнем: блокирующая, исправимая или на усмотрение автора. Правку вносит отдельная программа по цитате, а спорное всегда уходит к человеку, читающему по-казахски.
Слои проверки названы так же, как в русской Редколлегии, по образцу которой сделан набор: там слои носят имена Чуковского, Аграновского, Розенталя, Мильчина. Здесь гигиена текста зовётся Алтынсарин, сверка с оригиналом — Валиханов, термины — Шакарим; за будущими проходами по норме, смыслу и следам машинного письма закреплены Байтурсынов, Ауэзов и «Слопотрон-kk».
Термины по узусу
Узус — от латинского usus, «употребление» — это то, что сложилось в живой речи, в отличие от предписанного правилом. Набор не придумывает казахских слов для всякого понятия и не берёт чужое без разбора: он считает, как пишут на самом деле. В корпусе из 840 тысяч слов «цифрлық» встречается в 98% случаев, «жоба» — в 92% против «проект»; за ними набор и следует. Решение автора стоит выше счёта: «объект», «концепция», «партнёр» оставлены международными.
Что дальше
Готов первый слой — скрипты. Впереди проходы с языковой моделью и эталонный набор из 150–300 предложений, размеченных носителем языка: без него нельзя честно сравнить казахские модели, например KazLLM и Qwen3.5 Kazakh от ISSAI Назарбаев Университета.
Лицензия — GPL-3.0, нужен Python 3.8 или новее, описание есть на русском, английском и казахском. Помочь может всякий, кто читает по-казахски.
Лонгрид о проекте на webmarka.kz: что это, зачем и как пользоваться.